
Le petit dernier vient de griller son grand frère sur un test de code, et pour moitié prix en plus. Claude Sonnet 5.5, lancé par Anthropic le 28 septembre, n’a rien d’une révolution. Pourtant, c’est peut-être lui que vos équipes utiliseront vraiment, tous les jours.
Six jours plus tôt, Anthropic dévoilait Opus 5.5, le haut de gamme de sa nouvelle série. Sonnet en est le complément plus rapide et moins cher. Haiku 5.5, la version la plus légère, suivra dans les prochaines semaines. Du coup, la vraie question pour un décideur change. Ce n’est plus « quel est le meilleur modèle ? », c’est « lequel paie-t-on pour quoi faire ? ».
Plus rapide, moins cher : ce que promet Claude Sonnet 5.5.
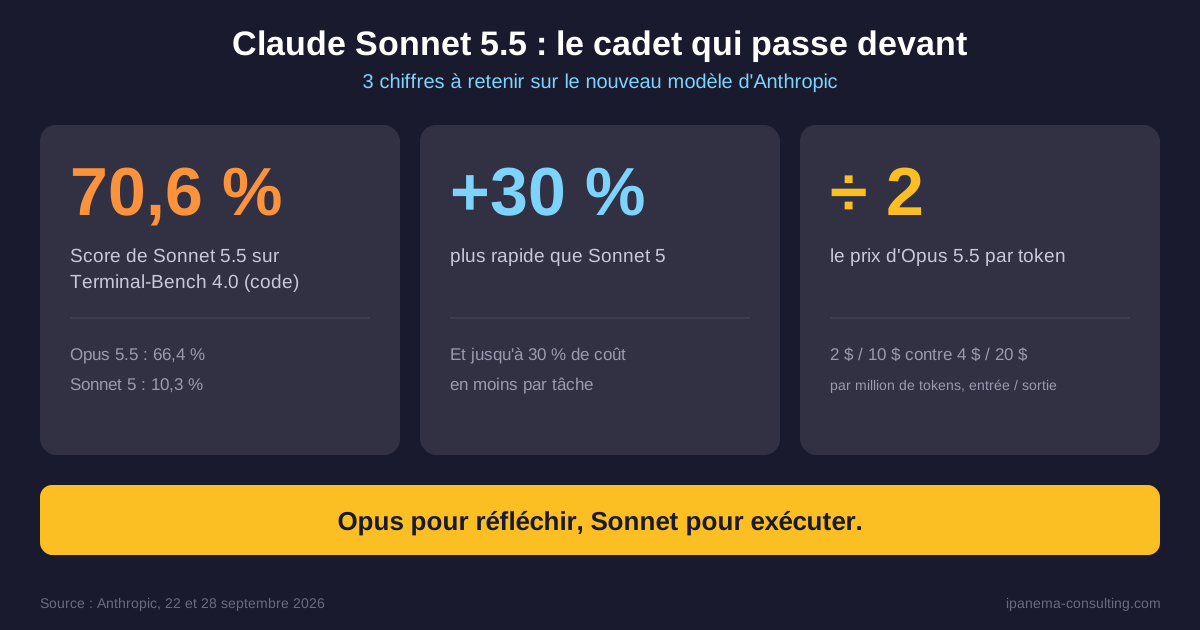
Commençons par le portefeuille, parce que c’est toujours là que ça se joue. Claude Sonnet 5.5 garde le tarif de son prédécesseur : 2 dollars par million de tokens en entrée, 10 dollars en sortie. Un token, c’est un petit morceau de mot, l’unité que facturent les éditeurs d’IA. Opus 5.5 coûte le double, avec 4 et 20 dollars.
En revanche, le modèle a besoin de moins de tokens pour accomplir le même travail. D’après les tests d’Anthropic, la note baisse donc jusqu’à 30 % par tâche. Il génère aussi ses réponses plus de 30 % plus vite que Sonnet 5. Cette histoire de consommation, on l’avait déjà croisée avec ce fameux bouton pour gérer ses tokens apparu avec Opus 4.8. Ici, c’est le modèle lui-même qui fait des économies.
Le code, terrain de jeu de Claude Sonnet 5.5.
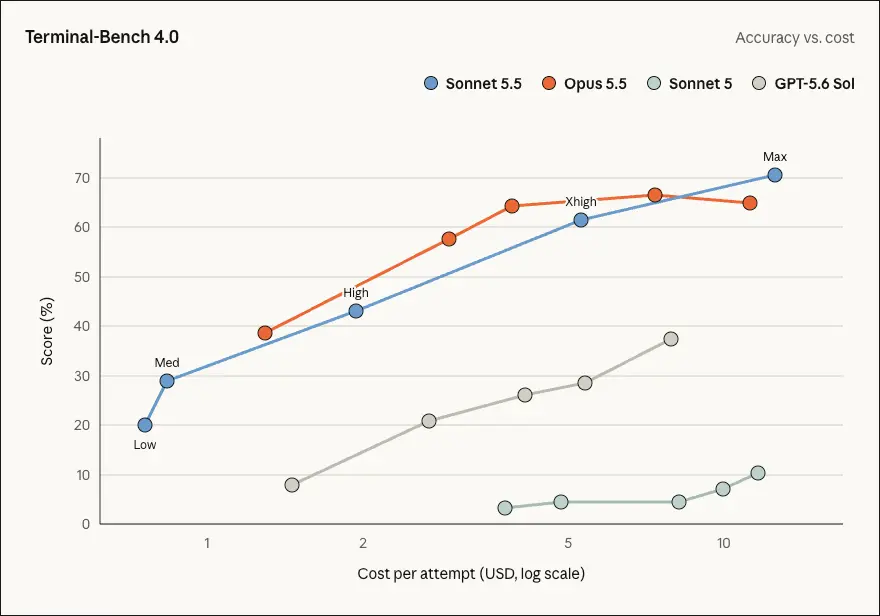
Le chiffre qui fait lever un sourcil, le voici. Sur Terminal-Bench 4.0, un test où l’IA enchaîne des tâches de pro en ligne de commande, Claude Sonnet 5.5 atteint 70,6 %. Sonnet 5 plafonnait à 10,3 %. Et Opus 5.5 ? Il affiche 66,4 %. Oui, le cadet passe devant.
Pas de panique, ce n’est qu’un test parmi d’autres. Mais il confirme une tendance. Pour le codage agentique, où l’IA avance seule sur plusieurs étapes, un modèle rapide et sobre devient vite plus utile qu’un modèle brillant mais gourmand. D’ailleurs, sur CursorBench, qui reprend des tâches tirées de vraies sessions de développeurs, Sonnet 5.5 reste à peu près à deux points d’Opus.
Au bureau : documents, tableurs et diapos.
Claude Sonnet 5.5 ne se contente pas de coder. Sur GDPval-AA, qui mesure des tâches réelles dans 44 métiers, Sonnet 5.5 affiche 1844 points contre 1846 pour Opus 5.5. Autant dire à égalité. Sonnet 5, lui, restait loin derrière, à 1449.
Anthropic raconte aussi un test interne. À partir des résultats trimestriels d’une entreprise cotée et d’un modèle de présentation, le modèle a produit un rapport de dix diapositives, et deux experts ont jugé ce premier jet prêt à l’envoi. Prenez ça avec des pincettes, c’est un test maison. Reste que la promesse est sérieuse pour fabriquer des documents ou des tableurs.
Et pour la petite histoire, c’est le premier Sonnet à venir à bout de Pokémon Rouge en ne voyant que des captures d’écran. Ça fait sourire. Puis on se dit qu’un agent qui navigue dans vos outils fait exactement ça : regarder un écran et décider où cliquer.
Ce que Claude Sonnet 5.5 ne remplace pas.
Soyons honnêtes : Opus 5.5 reste nettement meilleur dès que le travail devient long, flou, et qu’il réclame du jugement. Anthropic le dit elle-même, les scores ne racontent qu’une partie de l’histoire. La répartition la plus logique ressemble donc à ceci : Opus pose l’architecture, Sonnet exécute au quotidien. Autrement dit, ce n’est pas un remplaçant, c’est un coéquipier.
Côté sécurité, il y a aussi du nouveau. Claude Sonnet 5.5 est le premier Sonnet livré avec des garde-fous en cybersécurité, parce que ses capacités dans ce domaine ont fortement progressé. Corriger un bug ne pose aucun souci. En revanche, les tâches les plus risquées retombent visiblement sur Sonnet 5, et les défenseurs pourront candidater à un programme de vérification pour un accès plus large. Anthropic ajoute des protections contre la distillation, cette extraction massive des capacités d’un modèle par des comptes jetables.
Alors, on l'adopte ?
Mon avis, sans détour : pour l’essentiel du travail courant, Claude Sonnet 5.5 suffit, et votre facture vous dira merci. Gardez Opus pour les dossiers qui demandent de la réflexion longue. Pour une PME comme pour un grand compte, le calcul est simple. Deux modèles qui font à peu près le même travail, dont l’un coûte moitié moins : la décision se prend vite. Dans les applications Claude, l’effort par défaut est réglé sur « moyen », ce qui convient à la plupart des usages.
Le meilleur test reste le vôtre : trois tâches réelles, un chrono, la facture à la fin. Anthropic publie le détail de ses mesures sur sa page de lancement. Et Haiku 5.5 arrive vite, donc la question du bon modèle au bon endroit n’a pas fini de se poser.
